- 調査
AIのSEO、知らないと手遅れ「更新の〆切」とその対応方法
「調べ物は、まずAIに聞く」―そんな行動が急速に当たり前になってきました。
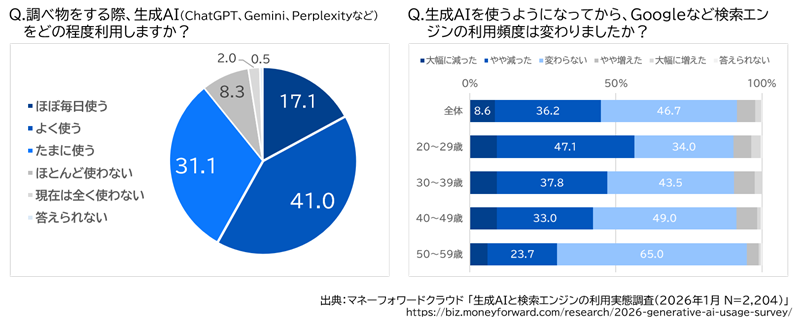
マネーフォワードが2026年1月に社会人2,204名へ行った調査では、調べ物の際に生成AIを「ほぼ毎日使う/よく使う」と答えた人が58.1%にのぼりました。一方で、検索エンジンの利用頻度が「減った」と答えた人は44.8%、20代に絞ると57%。
「検索からAIへ」のシフトが、若い世代を中心に進んでいます。
商品やサービスの認知は、これからは「広告で訴求する」「検索で見つけてもらう」だけでなく「AIに語ってもらう」時代に入りつつあります。
今回は「AIに語ってもらう」ための対策(GEO、LLMO、AIOなどの様々な言葉があります)として、押さえておきたい知識をご紹介します。
AIの知識には”締め切り”がある
生成AIは、ある時点までのデータを学習して作られています。ChatGPTが登場した頃は意識していたこの”締め切り”ですが、最近は検索して最新情報も答えてくれるので、つい忘れてしまっている方もいらっしゃると思います。この学習データの締め切りを「カットオフ(knowledge cutoff)」と呼びます。
つまり、AIの”知識”には期限があります。カットオフより後に起きたことは、本来は知りません。そして、この”知識”に無いことを問われる時に使うのが”検索”です。
ちなみに、9月3日に発表されたばかりの
GPT6-Astraのカットオフは2026年4月30日です。
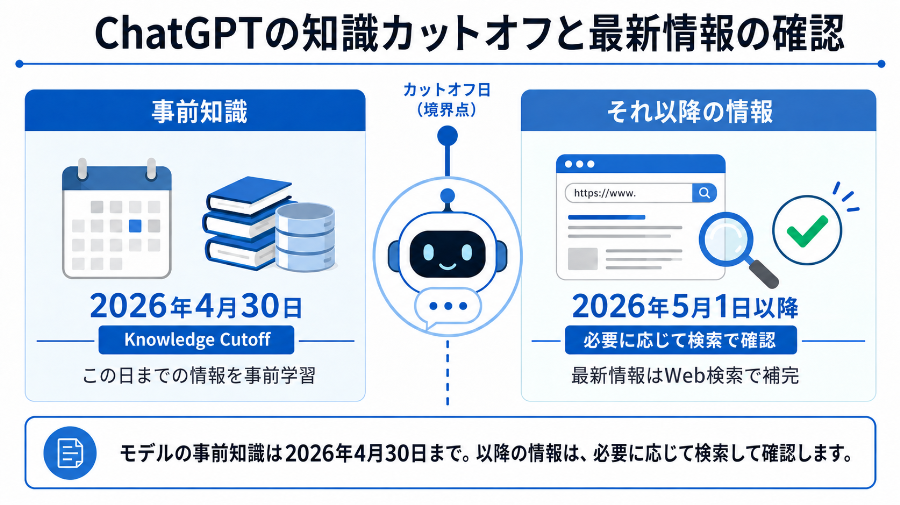
このカットオフ以降の情報を確認する”検索”には、二つの注意点があります。
- 検索が常に働くとは限らない。学習データだけで答えてしまうこともあります
- 検索しても、そもそもWeb上に情報がなければ拾えない
そして、学習データにも検索結果にも根拠がないとき、AIは”それらしい答え”を作ってしまうことがあります。いわゆるハルシネーション(誤情報の生成)です。
先ほどのGPT-6 Astraであれば、カットオフ「2026年4月30日」より後に発売された商品は、当然ながら”知識”の中に情報はありません。
そして、例えば既存のカテゴリーにおいて、ある商品がリニューアルした場合、そのリニューアル情報を求めてChatGPTが”検索”をかけるとは限りません。
目次
調査法①:カットオフの時期を知る
まずは、現在も圧倒的なシェアを誇るChatGPTや次点のGeminiのカットオフを調べましょう。
- AIに直接聞く ―「あなたの学習データはいつまでですか?」
- 提供元の公式ページで、モデルのカットオフを確認する
(※提供元:ChatGPTはOpenAI、GeminiはGoogle)
| モデル | カットオフ |
| GPT-6 Astra | 2026年4月30日(公開 同年9月3日) |
| GPT-5.6 Sol | 2026年2月16日(公開 同年7月9日) |
| Gemini 3.6 Flash | 2026年3月(公開 同年7月21日) |
2026年9月15日現在、主要な生成AIのカットオフが半年以上前であることが分かりました。AIの”知識”=学習データの中に、その商品・サービスの情報はあるのか。あったとしたら、どう認識されているのか?では、無かったとしたら?
これからのマーケティング、プロモーションには、これまでの活動に加えて「AIに語ってもらう」ための施策も必要になると考えております。
AI回答の根拠が”知識”=事前学習なのか、”検索”なのかで対策が変わります。”知識”にはカットオフの期限があり、現状は公開までに4~5ヵ月要しています。適切な対策をプランニングするためには、現状を知ることが第一で、そのうえで具体的な対策を選択しなくてはなりません。
カットオフという仕組みを知ると、自社をどう見せていくかの打ち手が、短期と中長期の2段階で見えてきます。
短期:新商品を、AIがまだ知らない場合
カットオフ以降に、新しく立ち上げたサービスや商品は、ChatGPT・Gemini・Copilot・ClaudeのいずれのモデルのAIにもまだ学習されていません。
特に、新しいカテゴリと言えるものであれば、どのAIの”知識”にも無い状態です。
裏を返せば、ここは”検索”(SEO)対策で取りにいくフェーズです。
AIが”知識”で答えられない質問の時、AIは”検索”で情報を探します。立ち上げ直後こそ、検索経由で見つけてもらう施策が素直に効きます。
「新しいからAIに載っていない」を、弱みではなく、今やるべきことの合図として捉えるのがポイントです。
中長期:AIに”語られる”存在を目指す
問題はその先です。
AIに「あの商品はこういうモノだ」と認識され、既に”知識”にある場合。あるいは、同じカテゴリの競合は”知識”にあるのに、自社の商品・サービスが”知識”に無い場合。
AIに望む内容で語ってもらうためには、自社サイトを整えるだけでは足りません。鍵になる施策の一つは、第三者サイトでの露出の蓄積です。
- 取材記事やインタビュー
- 業界メディアへの寄稿
- 比較・まとめサイトへの掲載
- SNSでの言及や口コミ
AI(LLM:大規模言語モデル)は、あちこちで、かつ多様な表現で語られている情報ほど”知識”として正しく引き出しやすいという性質がある、という研究結果(※)があります。自社サイトで「自称」するだけでなく、第三者サイトで異なる表現で語っている情報が多いほど、学習でも検索でも参照されやすくなります。
現在のChatGPTの最新モデル(GPT-6 Astra)のカットオフが4月30日であり、公開の4ヵ月以上前であることを前回お伝えしましたが、AIの”知識”の更新には、長い時間が必要です。だからこそ、早く動いて露出を積み重ねていく商品・サービスが有利になります。
まず「今どう語られているか」を知る
とはいえ、いきなり露出を増やそうとしても、方向は定まりません。
最初の一歩は、AIの”知識”の中で自社および競合が、今どこで・どう語られているかを把握することです。
現状が分かって初めて、「どのメディアに」「どんな切り口で」露出を仕込むかの目標が定まり、戦略が立てられます。
調査法②:事前学習データの状況を把握する
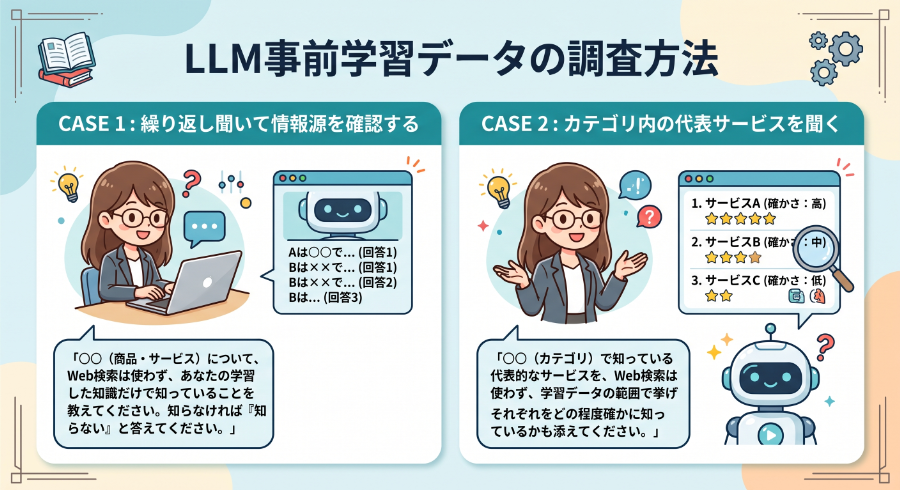
AIに繰り返し聞き、回答の傾向を測定する
○○(商品・サービス)について、Web検索は使わず、
あなたの学習した知識だけで知っていることを教えてください。
知らなければ「知らない」と答えてください。
○○(カテゴリ)で知っている代表的なサービスを、Web検索は使わず、
学習データの範囲で挙げてください。
それぞれをどの程度確かに知っているかも添えてください。
AIの回答内容はプロンプトによって変わりますし、同じプロンプトで質問するたびに変わります。同じモデルで、繰り返し、繰り返しプロンプトを投げて、回答の傾向を測定する必要があります。
弊社では、こうしたAIがどう語っているのかの調査を承っております。
また、中長期的に「AIに語ってもらう」ために把握しておくべき、第三者サイトやSNS上での露出状況のリサーチ・分析も承っております。AIが検索した際にどの情報源を引用しているかの測定も、専用ツールを用いてサポートいたします。
最初の下調べとして、お気軽にご相談ください。
その他、資料作成、SNS話題量調査、各種レポート作成、サイト/LP校正、
翻訳など、クライアント様のニーズに合わせて幅広く業務代行しております。
弊社でお手伝いできることがございましたら、なんなりとお申しつけください。
(※)出典
※Allen-Zhuら(2023).
Physics of language models: Part 3.1,
knowledge storage and extraction (arXiv:2309.14316v3). arXiv.
https://doi.org/10.48550/arXiv.2309.14316
※ Kandpalら(2023).
Large language models struggle to learn long-tail knowledge.
Proceedings of the 40th International Conference
on Machine Learning (ICML 2023).
https://doi.org/10.48550/arXiv.2211.08411
人気の記事
-
AIのSEO、知らないと手遅れ「更新の〆切」とその対応方法
-
英数字だけフォントがバラバラ!パワポ設定での解消法
-
AIで出力した文章のコピペ崩れを防ぐ方法
-
SNS分析の9割は、キーワード選定で決まる ─ 白黒ポテチが証明した事実
-
ミスタードーナツ「もっちゅりん」SNS分析速報レポート “幻のドーナツ”復活、「買えた」「売り切れ」が交差した発売日の購買行動
-
SNS調査で判明! 筋トレサプリの意外な活用実態
-
SNS分析・オンラインニュース分析でたどる2026年W杯:日本代表戦、熱狂の裏側
-
自由回答は「まず図で見る」。共起ネットワーク図活用術
-
日英併記で完璧!メール自動返信テンプレ集
-
ポケパークSNS分析 2つのピークにみる「拡散構造」の違い